JEV de TypeSafe AI es un modelo de inteligencia artificial que no escribe texto: recibe datos y devuelve una decisión. TypeSafe AI lo lanzó en acceso anticipado el 15 de septiembre de 2026, y su apuesta es simple. Si tu software solo necesita saber si un mensaje es una queja, si un candidato cumple el perfil o qué herramienta toca usar, no hace falta pagar por un modelo que redacte párrafos para llegar a eso.
Todavía no tengo acceso a JEV, porque entra por lista de espera. Por eso todo lo que cuento sale de la documentación y del anuncio oficial de TypeSafe, y de análisis de terceros. Las cifras de velocidad y precio las publica la propia empresa. Si no programas, ve directo a la sección sobre para qué sirve JEV en un negocio.
Qué es JEV de TypeSafe AI en pocas palabras
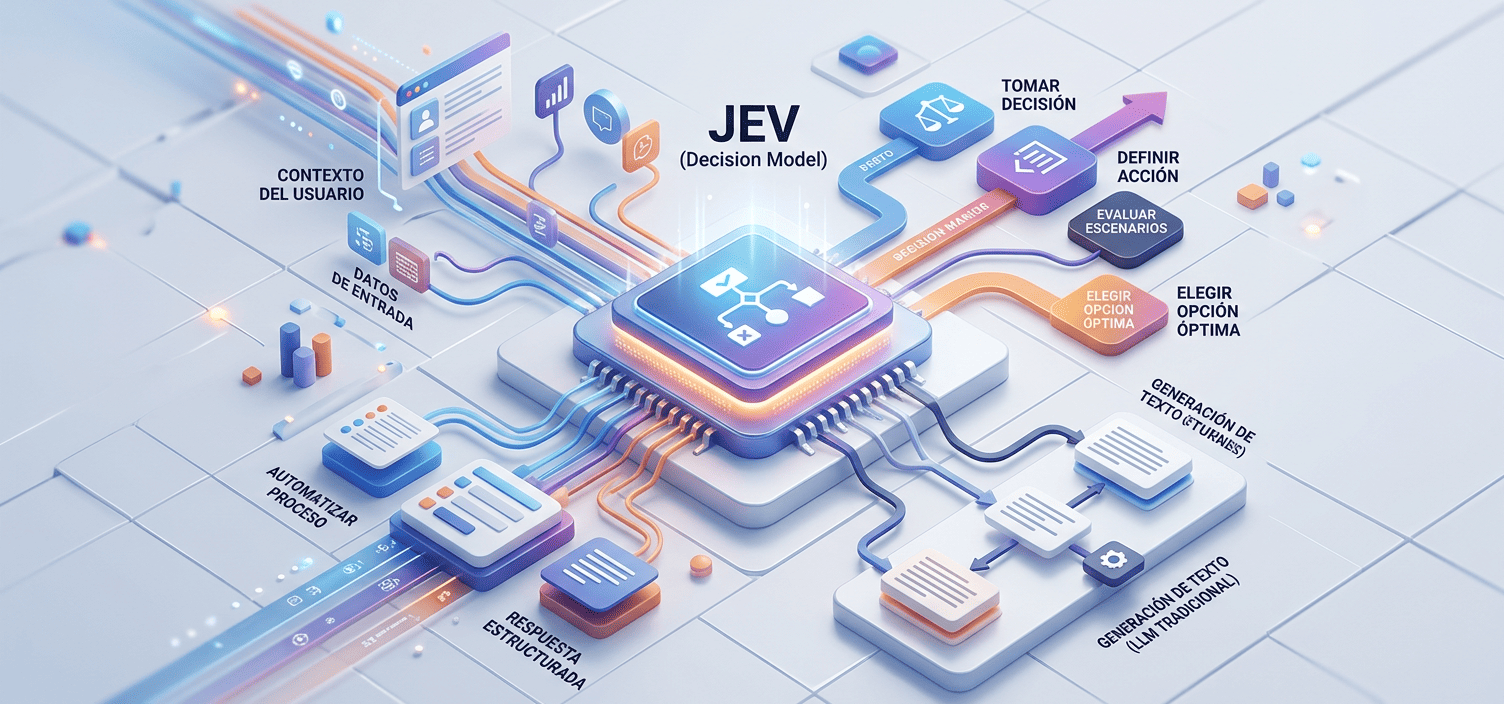
TypeSafe AI llama a JEV un modelo System One. Es una etiqueta para un tipo de IA distinto al de ChatGPT, Claude o Gemini: en lugar de generar texto palabra por palabra, devuelve valores con un formato fijo, como un sí o no, una opción de una lista o un puntaje.
Una analogía ayuda. Un modelo de lenguaje es como un empleado que lee tu correo y te redacta una respuesta. JEV es el que mira el correo y marca una casilla: urgente, normal o spam. No conversa, pero marca rápido, y esa casilla es justo lo que tu software necesita para seguir con el siguiente paso.
| Dato | Valor |
|---|---|
| Empresa | TypeSafe AI |
| Tipo de modelo | System One: devuelve decisiones tipadas, no texto |
| Lanzamiento | 15 de septiembre de 2026, en acceso anticipado |
| Acceso | Lista de espera, mediante una API alojada por TypeSafe |
| Entrada | Texto o JSON con el estado, más una o varias preguntas |
| Salida | Opción, puntaje o verdadero o falso, con probabilidades y confianza |
| Precio según TypeSafe | $0.042 por millón de tokens de entrada, salida gratis |
| Límite de opciones | 255 por pregunta de elección |
| Imágenes | No las admite por ahora |
La empresa lo resume como una llamada a función con inteligencia de frontera: entra un estado sin estructurar y salen decisiones tipadas con probabilidades.
Cómo funciona JEV: estado, preguntas y respuestas tipadas
Según la documentación, envías dos cosas en una sola petición. La primera es el estado, que son tus datos en texto o JSON: un correo, un ticket, una línea de registro. La segunda es una o varias preguntas, con el formato de respuesta ya definido.
JEV evalúa cada pregunta en paralelo y por separado contra el mismo estado. Por eso, añadir más preguntas casi no cambia el tiempo de respuesta. Aun así, la documentación recomienda mantener cada pregunta atómica y combinar los factores en tu propio código.
Los tres tipos de pregunta de JEV
- Elección: escoge una opción de una lista y devuelve la elección, las probabilidades y la confianza.
- Puntaje: puntúa el estado según una rúbrica que tú defines, también con probabilidades y confianza.
- Verdadero o falso: responde si una afirmación es cierta y devuelve un valor entre 0 y 1. La documentación la llama noul.
Las preguntas de elección admiten hasta 255 opciones. Con más, TypeSafe usa un proceso en dos etapas que añade algo de latencia, según su anuncio.
Por qué la confianza es lo más importante de JEV
Cada decisión llega con un número que indica qué tan seguro está el modelo. Eso permite una regla muy útil en automatización: si la confianza es alta, tu software actúa solo, y si es baja, manda el caso a una persona. TypeSafe entrena el modelo con un método propio, que llama RLCD, para que esas probabilidades sean honestas.
Pero ojo con esto. Que la empresa diga que están calibradas no significa que lo estén con tus datos, y ningún tercero lo ha verificado todavía. Antes de apoyar una decisión importante en ese número, mídelo con tus propios casos.
Para qué sirve JEV en un negocio
TypeSafe lo recomienda para tareas donde la lógica escrita a mano se rompe con facilidad: clasificar, enrutar, puntuar, extraer y bifurcar. En la práctica, eso se ve así:
- Clasificar los mensajes que llegan: compra, soporte, queja o spam.
- Enrutar un ticket al equipo correcto.
- Puntuar un lead o un candidato contra una rúbrica.
- Verificar un dato que sacó otro modelo, por ejemplo si el total de una factura es correcto.
- Vigilar lo que entra y sale de un modelo de texto, para detectar intentos de jailbreak o respuestas fuera de política.
El caso de cliente que destaca la empresa en su página es el de Jack & Jill, en el filtrado de candidatos. Según TypeSafe, redujeron el costo 88%, duplicaron la velocidad y mantuvieron la calidad, y pasaron de prueba a producción en 10 días. Es un solo caso y lo cuenta el proveedor, así que tómalo como una pista y no como una garantía.
Si ya usas agentes para atender clientes, en mi artículo sobre agentes de IA para WhatsApp explico dónde encajan las decisiones y dónde la redacción.
Lo que JEV de TypeSafe AI no puede hacer
JEV no genera texto ni código, así que no sirve para chatear ni para redactar una respuesta. Tampoco acepta imágenes por ahora, solo texto estructurado. Y como es una API cerrada, no hay pesos para descargar ni forma de correrlo en tu propio servidor.
Hay una limitación menos obvia. JEV decide sobre el estado que tú le pasas, así que la información que necesita tiene que viajar en esa petición. Si la decisión depende de tu catálogo o de tus políticas, tú las incluyes, igual que harías al conectar un modelo con RAG.
Por último, un matiz sobre la promesa de cero alucinaciones. Como JEV solo puede elegir entre las opciones que le das, no inventa una herramienta ni devuelve un formato roto. Sin embargo, puede elegir la opción equivocada, y el formato correcto no garantiza una decisión correcta.
Cuánto cuesta JEV y qué tan rápido es, según TypeSafe
La empresa cobra $0.042 por millón de tokens de entrada y no cobra la salida. Para ponerlo en contexto, TypeSafe compara con un rango de $0.20 a $10 por millón de entrada en los modelos de lenguaje, cuya salida cuesta cerca de cinco veces más. Por ejemplo, GPT-6.1 Sol cuesta $2 de entrada y $10 de salida por millón de tokens, según la documentación de OpenAI, como conté en mi análisis de GPT-6.1 Sol. Con esos precios, la entrada de JEV sale unas 48 veces más barata.
En velocidad, TypeSafe habla de 70 a 500 milisegundos por respuesta y de entre 40 y 200 veces más rápido que los modelos de frontera en tareas con forma de decisión. En su flujo de ejemplo, una decisión costó $0.000081 y tardó 0.114 segundos, frente a $0.013880 y 8.566 segundos con modelos de lenguaje.
Aun así, hay que leer esas cifras con cuidado. Las pruebas las diseñó la propia empresa, las midió desde laptops en la costa oeste de Estados Unidos y las compara con respuestas de referencia promediadas de GPT-6 Astra y Claude Fable 5.1, algo que ella misma admite que puede sesgar el resultado. TypeSafe también reconoce que no puede probar que su precio no esté subsidiado.
¿Vale la pena probar JEV de TypeSafe AI?
Yo lo probaría, pero en un paso concreto y no en todo el sistema. En un agente de atención por WhatsApp, buena parte de las llamadas a un modelo grande son clasificaciones disfrazadas: ¿esto es una consulta de precio o de soporte?, ¿el cliente está molesto?, ¿lo puede resolver el agente solo? Para eso un modelo de texto es una herramienta enorme.
El plan de prueba es sencillo. Toma 200 mensajes reales que ya tengan su respuesta correcta, pídele a JEV que los clasifique y mide tres cosas: cuántas veces acierta, cuánto tarda y cuánto cuesta cada decisión. Si la confianza separa bien los casos fáciles de los dudosos, tienes un ahorro real. Si no, perdiste una tarde. Y mientras llega tu acceso, revisa cuántas de tus llamadas a un modelo son decisiones y cuántas son redacción, algo que también te ayuda a ahorrar tokens hoy.
Fuentes y documentación oficial
- Presentación de los modelos System One y JEV (TypeSafe AI): el anuncio oficial con precios, velocidad y limitaciones.
- Documentación de JEV (TypeSafe AI): tipos de pregunta y formato de respuesta.
- Análisis de JEV y los modelos System One (TrueFoundry): lectura externa que separa las cifras propias de TypeSafe.
- JEV, un modelo de decisión para agentes de IA (Beam AI): cómo encaja en un agente junto a un modelo de texto.
Preguntas frecuentes
¿Qué es JEV de TypeSafe AI?
Es un modelo de IA de la clase System One que devuelve decisiones en vez de texto. Recibe un estado y una lista de preguntas, y responde con una opción, un puntaje o un verdadero o falso, cada uno con su probabilidad. TypeSafe AI lo lanzó en acceso anticipado el 15 de septiembre de 2026.
¿Cuánto cuesta JEV?
Según TypeSafe, $0.042 por millón de tokens de entrada, y la salida es gratis. La propia empresa avisa de que no puede demostrar que ese precio no esté subsidiado y de que espera que baje con el tiempo, así que confirma la tarifa vigente antes de calcular un presupuesto.
¿JEV reemplaza a ChatGPT, Claude o Gemini?
No. JEV no genera texto, código ni conversación, que es justo lo que hacen esos modelos. Funciona mejor como una capa que toma decisiones rápidas y baratas, mientras un modelo de lenguaje se encarga de redactar cuando hace falta.
¿Cómo puedo acceder a JEV?
Por ahora, mediante una lista de espera. TypeSafe va admitiendo desarrolladores en su consola de API, y no hay pesos descargables ni una opción para correrlo en tu propio servidor.