Qué es RAG, en una frase: la técnica que evita que tu chatbot invente un precio que no existe. Le preguntas cuánto cuesta tu plan premium y te da una cifra inventada, no porque el modelo sea malo, sino porque nunca vio tu lista de precios real. Un LLM solo sabe lo que aprendió en su entrenamiento, y eso tiene fecha de corte y cero idea de tus datos internos.
Ahí es donde entra RAG (Retrieval-Augmented Generation), la técnica con la que un chatbot responde con información real y verificable en vez de improvisar. Te explico qué es, cómo funciona y por qué tu proyecto de IA probablemente ya lo necesita. Si no programas, ve directo a las secciones sobre qué es RAG y qué cambia para tu negocio. Si eres técnico, la parte de cómo funciona y de por qué falla un sistema RAG es la que más te sirve.
Qué es RAG (Retrieval-Augmented Generation)
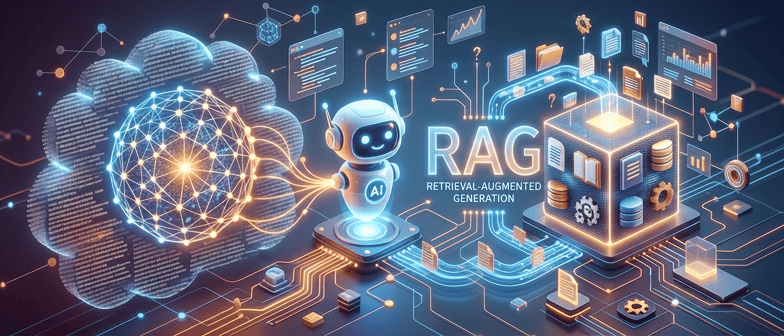
RAG es una técnica que conecta un modelo de lenguaje con una fuente externa de información (tus documentos, tu base de conocimiento, tu catálogo) para que busque los datos relevantes antes de generar una respuesta, en vez de responder solo con lo que memorizó durante el entrenamiento.
La analogía más simple: un LLM sin RAG es como un estudiante que rinde un examen a libro cerrado, confiando solo en su memoria. RAG le da el libro abierto: primero busca la página correcta, y luego responde basado en lo que encontró. El concepto se formalizó en 2020 en el paper original de Lewis y colegas sobre Retrieval-Augmented Generation, y desde entonces se convirtió en el enfoque habitual para chatbots con datos propios.
Qué es RAG y por qué un LLM solo no alcanza
Un modelo de lenguaje entrenado hace meses no conoce tus precios de hoy, tu inventario actual ni la política que actualizaste la semana pasada. Cuando no sabe la respuesta, muchas veces no dice «no sé»: la inventa con total seguridad. Eso es lo que se conoce como alucinación, y es el problema número uno que frena la adopción de IA en negocios reales.
Reentrenar el modelo cada vez que cambia un dato es lento y costoso. RAG resuelve esto sin tocar el modelo: actualizas la fuente de datos y la próxima respuesta ya refleja el cambio.
Cómo funciona por dentro, paso a paso
- Indexación: tus documentos se dividen en fragmentos (chunks) y se convierten en vectores (embeddings): listas de números que representan su significado, de modo que los textos parecidos quedan cerca entre sí.
- Recuperación (retrieval): cuando alguien hace una pregunta, el sistema busca en esos vectores los fragmentos más relevantes.
- Generación aumentada: el LLM recibe la pregunta junto con los fragmentos encontrados, y genera una respuesta basada en ese contexto real.
RAG no hace que el modelo sepa más: hace que responda con lo que tú sabes, no con lo que recuerda de su entrenamiento.
Qué separa un RAG que funciona de uno que falla
Montar RAG es fácil. Lograr que recupere el fragmento correcto es lo difícil, y ahí se gana o se pierde la calidad. Por ejemplo, un fragmento cortado sin contexto («el plan cuesta 20 dólares», sin decir de cuál plan) confunde al buscador. Por eso se combinan tres piezas: fragmentos que conservan su contexto, búsqueda por significado junto con búsqueda por palabras exactas, y un reranker, un segundo filtro que reordena los resultados antes de enviarlos al modelo.
Anthropic midió esto en sus propias pruebas con su técnica de Contextual Retrieval. Agregar contexto a cada fragmento redujo los fallos de recuperación un 35%, sumar búsqueda por palabras exactas (BM25, el método clásico de los buscadores) lo llevó al 49%, y añadir reranking al 67%. Son cifras del propio proveedor sobre sus datos, así que tómalas como orden de magnitud, no como garantía para tu caso.
RAG vs fine-tuning: no son lo mismo
El fine-tuning (ajustar el modelo con ejemplos propios) reentrena al modelo para que cambie su comportamiento o estilo; es costoso y hay que repetirlo cada vez que los datos cambian. RAG no toca el modelo: le da acceso a información actualizada en el momento de la consulta. Para la mayoría de los casos de negocio (soporte, ventas, documentación interna), RAG es más rápido de implementar y más barato de mantener.
¿Y si el modelo ya acepta documentos enormes?
Los modelos actuales admiten contextos muy largos, y es tentador pegar todos tus documentos en el prompt y olvidarte de RAG. Eso funciona para analizar un solo documento. Pero con una base de conocimiento grande que cambia, pagas por procesar todo ese texto en cada pregunta y la respuesta tarda más. En la práctica se combinan: RAG encuentra lo relevante y el contexto largo sirve para razonar sobre lo encontrado. Si te preocupa el costo, mira mi guía para ahorrar tokens en IA.
Qué cambia para tu negocio
Si estás construyendo un chatbot, un asistente interno o un agente de IA, RAG es lo que separa una demo bonita de una herramienta confiable. Sin RAG, tu IA improvisa. Con RAG, responde con tus datos reales, y eso es lo que un cliente necesita para confiar en la respuesta. Si ya tienes claro esto, el siguiente paso es entender en qué se diferencia RAG de un agente de IA y cuándo conviene usar cada uno.
Para ir un paso más allá, mira las bases de datos vectoriales y esta checklist para elegir modelo de IA.
Fuentes y documentación oficial
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., 2020): el artículo original que definió la técnica.
- Contextual Retrieval (Anthropic): cómo mejorar la recuperación de fragmentos y por qué ayuda el reranking.
Preguntas frecuentes
¿Qué significa RAG en inteligencia artificial?
RAG (Retrieval-Augmented Generation) es una técnica que combina la búsqueda de información en una fuente externa con la generación de texto de un modelo de lenguaje, para dar respuestas basadas en datos reales y actualizados.
¿RAG reemplaza al fine-tuning?
No necesariamente. RAG resuelve el problema de dar contexto actualizado; el fine-tuning ajusta el comportamiento o estilo del modelo. Muchos proyectos usan ambos según lo que necesiten.
¿Se acaban del todo las alucinaciones?
Las reduce mucho al basar la respuesta en información real, pero no las elimina al 100%: la calidad de la recuperación y del contenido indexado sigue siendo determinante.
¿Necesito un equipo de IA para implementarlo?
No. Hoy existen frameworks y servicios que simplifican buena parte del proceso; lo crítico es diseñar bien la recuperación, no programar el modelo desde cero.